Google Bigtable چیست؟ راهنمای کامل و آخرین تغییرات
مهیار طلوعی اصل ·
·
۱۲ دقیقه مطالعه
این مقاله در مهر ۱۴۰۵ بهطور کامل بازنویسی و با آخرین تغییرات سرویس بهروزرسانی شده است.
وقتی صحبت از ذخیرهسازی میلیاردها ردیف داده با تأخیر چند میلیثانیهای میشود، نام Bigtable یکی از اولین گزینههایی است که به ذهن مهندسان داده میرسد. Bigtable در اصل یک سیستم ذخیرهسازی داخلی گوگل بود که سرویسهایی مثل جستوجو، Google Earth و Google Analytics روی آن ساخته شدند؛ امروز همان فناوری با نام Cloud Bigtable بهصورت یک سرویس کاملاً مدیریتشده در Google Cloud در اختیار همه قرار دارد.
در این راهنما میبینیم Bigtable دقیقاً چیست، معماری آن چگونه کار میکند، چه تأثیری بر پایگاهدادههای NoSQL متنباز گذاشته، چه زمانی باید از آن استفاده کرد (و چه زمانی نه) و در دو سال اخیر چه قابلیتهای تازهای به آن اضافه شده است.
بخش ۱ از ۱۲
Bigtable چیست؟
Bigtable یک پایگاهداده NoSQL از نوع Wide-column (ستونگسترده) و Key-value است. مقالهی اصلی گوگل آن را اینطور تعریف میکند: یک «نقشهی مرتبشده، چندبعدی، پراکنده (sparse) و توزیعشده». هر مقدار در Bigtable با سه مؤلفه آدرسدهی میشود: Row key، Column key و Timestamp؛ و خود مقدار صرفاً یک آرایهی بایت است که تفسیرش به عهدهی برنامه است.
Bigtable رابطهای نیست؛ یعنی جدولها اسکیمای ثابت، کلید خارجی و JOIN به شکل پایگاهدادههای SQL سنتی ندارند. در عوض برای حجم بسیار بالا طراحی شده است: میلیاردها ردیف، هزاران ستون و ترابایتها تا پتابایتها داده، با توان خواندن و نوشتن بالا و تأخیر کم.
تاریخچهی کوتاه
توسعهی Bigtable در گوگل از سال ۲۰۰۴ آغاز شد.
در سال ۲۰۰۶ مقالهی معروف «Bigtable: A Distributed Storage System for Structured Data» از Fay Chang، Jeffrey Dean، Sanjay Ghemawat و همکارانشان در کنفرانس OSDI 2006 منتشر شد. طبق همین مقاله، پروژههایی مثل ایندکس وب، Google Earth و Google Finance دادههایشان را در Bigtable نگه میداشتند.
در ۶ مه ۲۰۱۵ (۱۶ اردیبهشت ۱۳۹۴) گوگل نسخهی عمومی آن را با نام Cloud Bigtable و با رابط استاندارد Apache HBase API بهصورت بتا روی Google Cloud Platform معرفی کرد.
بخش ۲ از ۱۲
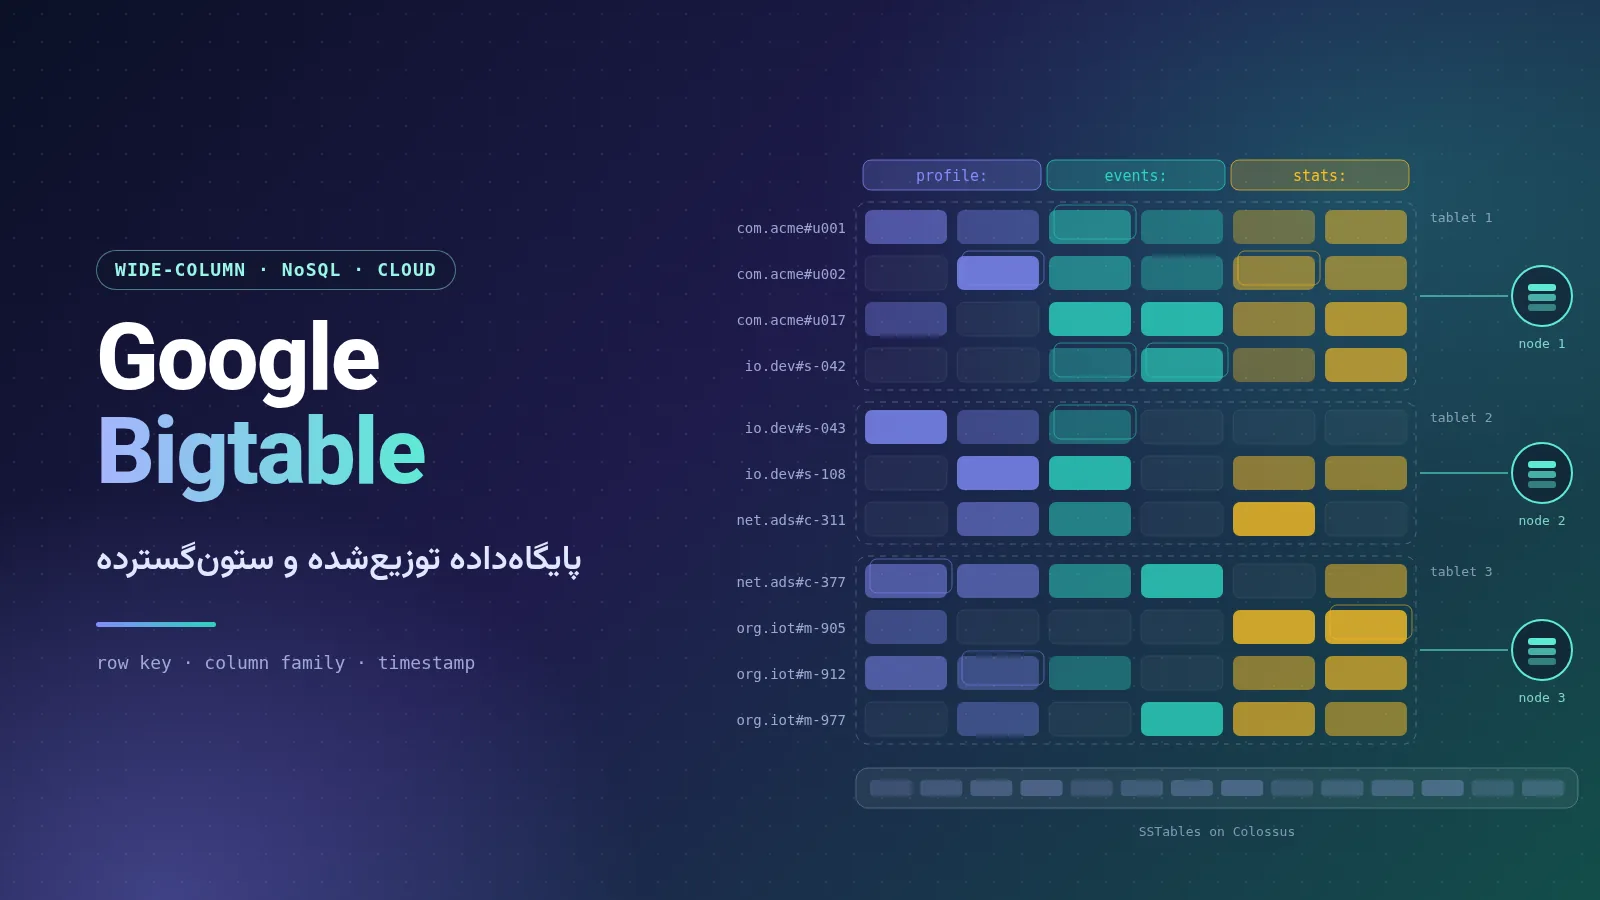
مدل داده: ردیف، Column family و نسخهها
درک مدل داده مهمترین قدم برای کار با Bigtable است، چون طراحی درست کلیدها مستقیماً روی کارایی اثر میگذارد.
Table: هر جدول یک نقشهی کلید-مقدار مرتبشده است.
Row key: تنها مقدار ایندکسشده در هر ردیف. ردیفها بر اساس Row key بهترتیب الفبایی (لغتنامهای) ذخیره میشوند.
Column family: گروهی از ستونهای مرتبط. خانوادههای ستون معمولاً از قبل تعریف میشوند و سیاستهایی مثل Garbage collection روی آنها اعمال میشود.
Column qualifier: نام ستون درون یک Column family؛ ستونها را میتوان بدون تغییر اسکیما و بهصورت پویا اضافه کرد.
Cell و Timestamp: محل تلاقی هر ردیف و ستون میتواند چند Cell داشته باشد که هر کدام نسخهای از داده با Timestamp یکتاست؛ بنابراین تاریخچهی تغییرات یک مقدار هم قابل نگهداری است.
Sparse بودن: اگر ستونی در یک ردیف استفاده نشود، هیچ فضایی اشغال نمیکند.
Tablet: هر جدول به بلوکهایی از ردیفهای پشت سر هم به نام Tablet تقسیم میشود (مشابه Region در HBase).
مثال کلاسیک مقالهی Bigtable، نگهداری کپی وب است: Row key آدرس وارونهی صفحه (مثلاً com.cnn.www) است، یک ستون محتوای صفحه را نگه میدارد و چند نسخه با Timestampهای مختلف نشان میدهد صفحه در زمانهای مختلف خزش چه شکلی داشته است.
بخش ۳ از ۱۲
معماری Bigtable چگونه کار میکند؟
در Cloud Bigtable همهی درخواستهای کلاینت ابتدا به یک سرور Frontend میرسند و سپس به یک Node (که در مقالهی اصلی Tablet server نامیده میشد) هدایت میشوند. Nodeها در یک Cluster قرار دارند و Cluster متعلق به یک Instance است.
جدایی محاسبه از ذخیرهسازی
نکتهی کلیدی معماری این است که داده هرگز روی خود Nodeها ذخیره نمیشود. Tabletها با فرمت SSTable روی Colossus (نسل بعدی Google File System) نگهداری میشوند و هر Node فقط به مجموعهای از Tabletها اشاره میکند. SSTable یک نقشهی پایدار، مرتب و تغییرناپذیر از کلید به مقدار است. نوشتنها هم بهمحض تأیید در لاگ مشترک Colossus ثبت میشوند. نتیجه:
جابهجایی Tabletها بین Nodeها بسیار سریع است، چون داده کپی نمیشود و فقط اشارهگرها بهروز میشوند.
بازیابی پس از خرابی یک Node سریع است و دادهای از دست نمیرود.
با افزودن Node، توان پردازش درخواستها تقریباً بهصورت خطی بالا میرود.
SSTable، ساختار LSM و Chubby
Bigtable از الگویی استفاده میکند که بعدها با نام LSM-tree (Log-Structured Merge) شناخته شد: نوشتنها ابتدا در لاگ و حافظه (memtable) ثبت میشوند، سپس به فایلهای SSTable تغییرناپذیر تبدیل و بهمرور ادغام (compaction) میشوند. همین ایده بعدها در LevelDB، RocksDB، HBase و Cassandra هم به کار رفت. در طراحی اصلی، سرویس قفل توزیعشدهی Chubby برای مدیریت Master، کشف Tablet serverها و نگهداری اطلاعات اسکیما استفاده میشد.
متعادلسازی بار و Hotspot
یک فرایند مدیریتی در هر Zone، Tabletهای پرترافیک یا بزرگ را نصف میکند، Tabletهای کوچک را ادغام میکند و آنها را بین Nodeها جابهجا میکند؛ همه بهصورت خودکار. با این حال، طراحی Row key هنوز حیاتی است: کلیدهایی که بهترتیب زمانی افزایش مییابند (مثل Timestamp در ابتدای کلید) همهی نوشتنها را به یک Tablet میفرستند و Hotspot میسازند. توصیهی رسمی این است که نوشتنها تا حد امکان یکنواخت پخش شوند و در عین حال ردیفهای مرتبط کنار هم قرار بگیرند.
بخش ۴ از ۱۲
تأثیر Bigtable بر دنیای NoSQL
مقالهی Bigtable، در کنار مقالههای GFS و MapReduce، یکی از پایههای جنبش Big Data بود:
Apache HBase تقریباً پیادهسازی متنباز مستقیم Bigtable روی HDFS است؛ به همین دلیل Cloud Bigtable از ابتدا با HBase API سازگار عرضه شد.
Apache Cassandra مدل دادهی ستونگسترده و موتور ذخیرهسازی مبتنی بر SSTable را از Bigtable و معماری توزیعشدهی بدون Master را از Amazon Dynamo گرفت.
ایدههای Bigtable در پروژههایی مثل Apache Accumulo و موتورهای ذخیرهسازی LSM مانند LevelDB (که آن هم از گوگل بیرون آمد) هم دیده میشود.
جالب اینکه حالا مسیر برعکس شده است: Bigtable در سالهای اخیر ابزارهایی برای مهاجرت مستقیم برنامههای Cassandra به خودش ارائه کرده است (جزئیات در بخش آخرین تغییرات).
بخش ۵ از ۱۲
Cloud Bigtable؛ سرویس مدیریتشده در Google Cloud
Cloud Bigtable همان موتور داخلی گوگل است که مدیریت زیرساختش را Google Cloud بر عهده دارد. مهمترین ویژگیهای آن طبق مستندات رسمی:
مقیاسپذیری خطی: توان سیستم متناسب با تعداد Nodeها افزایش مییابد.
تغییر اندازه بدون Downtime: میتوان Cluster را برای چند ساعت بزرگ و سپس دوباره کوچک کرد.
Autoscaling: پایش خودکار CPU و تنظیم تعداد Nodeها (عمومی از دسامبر ۲۰۲۱).
Replication: با افزودن Cluster دوم، تکثیر داده خودکار آغاز میشود و امکان Failover بین Clusterها و Regionها فراهم است؛ دسترسپذیری تا ۹۹٫۹۹۹٪ بسته به پیکربندی Replication و Routing طبق SLA.
Change streams: ثبت تغییرات جدول بهصورت لحظهای برای پردازش یا انتقال به BigQuery و Pub/Sub (عمومی از جولای ۲۰۲۳).
Data Boost: محاسبهی Serverless برای خواندنها و Queryهای سنگین تحلیلی بدون تأثیر بر Cluster اصلی برنامه.
اکوسیستم: کلاینتهای Java، Python، Go و…، سازگاری با HBase، کانکتورهای Spark، Kafka، Flink و Dataflow و یکپارچگی با BigQuery.
طبق جدول مقایسهی Editions، هر Node از نوع SSD تا حدود ۱۷٬۰۰۰ خواندن و ۱۴٬۰۰۰ نوشتن در ثانیه با تأخیر کمتر از ۵ میلیثانیه را پشتیبانی میکند.
مدل قیمتگذاری (بهصورت کلی)
هزینهی Bigtable از سه بخش اصلی تشکیل میشود:
Compute: تعداد Nodeهای Provisionشده، بهصورت ساعتی (حتی اگر Cluster بیکار باشد). نرخ Node به Edition بستگی دارد: Enterprise یا Enterprise Plus.
Storage: حجم دادهی ذخیرهشده بر حسب GiB؛ نوع ذخیرهسازی (SSD، HDD یا Tiered storage) روی نرخ اثر دارد.
Network: پهنای باند خروجی مصرفشده.
Data Boost و Backupها هم هزینهی جداگانه دارند و تخفیفهای تعهد مصرف یکساله و سهساله (CUD) هم وجود دارد. قیمتها بر اساس Region متفاوت است؛ برای عدد دقیق به صفحهی رسمی Pricing یا Pricing Calculator مراجعه کنید.
بخش ۶ از ۱۲
آخرین تغییرات و بهروزرسانیها (۲۰۲۴–۲۰۲۶)
Bigtable در دو سال اخیر از یک پایگاهدادهی صرفاً Key-value به سکویی با SQL، Viewهای پیوسته و قابلیتهای هوش مصنوعی تبدیل شده است. موارد زیر از یادداشتهای رسمی انتشار (Release notes) و وبلاگ Google Cloud استخراج شدهاند؛ تاریخها همان تاریخ اعلامشده در منبع است.
۲۰۲۴
آوریل ۲۰۲۴ — Authorized views (GA): کنترل دسترسی به زیرمجموعهای از دادههای جدول.
آوریل ۲۰۲۴ — Distributed counters (Preview): تجمیع در زمان نوشتن؛ در آگوست ۲۰۲۴ با توابع min، max، sum و HLL به نسخهی عمومی (GA) رسید.
آوریل ۲۰۲۴ — Data Boost (Preview) و یکپارچگی با LangChain (Preview).
مه ۲۰۲۴ — Spark connector (GA): خواندن و نوشتن با Spark SQL و DataFrame.
آگوست ۲۰۲۴ — SQL برای Bigtable (Preview): اجرای Query با GoogleSQL.
آگوست ۲۰۲۴ — Reverse ETL (GA): انتقال مستقیم داده از BigQuery به Bigtable با دستور EXPORT DATA.
سپتامبر ۲۰۲۴ — جستوجوی برداری: Similarity search با K-nearest neighbors در قالب Preview زبان SQL.
۲۰۲۵
فوریه ۲۰۲۵ — Data Boost (GA): سرویس محاسبهی Serverless برای Jobهای خواندن پرحجم.
آوریل ۲۰۲۵ (همزمان با Google Cloud Next ’25) — SQL به نسخهی عمومی رسید، همراه با قابلیت UNPACK برای خواندن دادههای سری زمانی به شکل جدولی؛ Continuous materialized views و Logical views در Preview معرفی شدند.
آوریل ۲۰۲۵ — Kafka sink (GA) برای اتصال مستقیم Apache Kafka، و Cassandra-Bigtable proxy adapter (Preview) برای اتصال برنامههای Cassandra با زبان CQL.
آوریل ۲۰۲۵ — جستوجوی برداری KNN (GA).
ژوئن ۲۰۲۵ — Data Boost برای تحلیل دادههای Bigtable در BigQuery (GA) بدون اثر بر Clusterهای برنامه.
جولای ۲۰۲۵ — Logical views (GA).
اکتبر ۲۰۲۵ — Cassandra proxy adapter (GA)، معرفی Tiered storage (Preview) برای نگهداری ارزانتر دادههای کماستفاده، و Vector store برای LangChain.
دسامبر ۲۰۲۵: پشتیبانی از تا پنج Continuous materialized view برای هر جدول؛ از جمله برای ساخت ایندکس ثانویهی ناهمگام (Asynchronous secondary index).
۲۰۲۶
فوریه ۲۰۲۶: کانکتور Flink نسخهی 0.3.2 با پشتیبانی از Apache Flink 2.1.0؛ MCP server برای Admin API (Preview)؛ و راهنمای مهاجرت از Vertex AI Feature Store (Legacy) به Bigtable.
مارس ۲۰۲۶: ابزارهای Bigtable در Agent Development Kit (ADK) به نسخهی عمومی رسیدند.
آوریل ۲۰۲۶ — Protobuf schemas و درایور JDBC (GA): Query روی فیلدهای پیامهای Protobuf ذخیرهشده و اتصال ابزارهای گزارشگیری.
آوریل ۲۰۲۶ — توسعهی SQL: توابع جغرافیایی (Geography)، Pipe syntax و Window functions (همه GA)، و کمک Gemini برای نوشتن SQL در Bigtable Studio (Preview).
آوریل ۲۰۲۶ — Continuous materialized views (GA) و Remote MCP server (GA) برای تعامل LLMها و عاملهای هوش مصنوعی با Bigtable.
آوریل ۲۰۲۶ — Bigtable Editions (GA): دو Edition با نامهای Enterprise و Enterprise Plus. در Enterprise Plus: In-memory tier با تأخیر خواندن زیر یک میلیثانیه (Preview)، Tiered storage تا ۶۴ ترابایت برای هر Node (بهجای ۳۲ ترابایت) و اجرای GoogleSQL با Data Boost.
آوریل ۲۰۲۶ — Bigtable subscriptions برای Pub/Sub (Preview): نوشتن مستقیم پیامهای استریم در جدول بدون نیاز به Dataflow.
مه ۲۰۲۶: ابزارهای مهاجرت از Aerospike (Preview) و نگهداری Backup تا ۳۶۵ روز در Enterprise Plus.
جولای ۲۰۲۶: Direct connectivity برای دور زدن Frontend و بهبود کارایی ترافیک واجد شرایط؛ و استفاده از Bigtable بهعنوان Backend ذخیرهسازی LMCache برای اشتراک KV cache مدلهای زبانی بزرگ (Preview).
آگوست ۲۰۲۶ — Parameterized views (GA): فیلتر پویای داده بر اساس پارامترهای برنامه و کاهش ریسک SQL injection.
اکتبر ۲۰۲۶: پشتیبانی Google Cloud Data Agent Kit (GA) برای مرور جدولها، طراحی اسکیما و اجرای GoogleSQL از داخل IDE یا عامل کدنویس.
بخش ۷ از ۱۲
یک مثال عملی
با ابزار خط فرمان cbt میتوان پس از یک تنظیم ساده، در چند دستور یک جدول ساخت، Column family اضافه کرد و داده نوشت و خواند:
# point cbt at your project and instance (once)
echo project = my-project >> ~/.cbtrc
echo instance = my-instance >> ~/.cbtrc

# create a table and a column family
cbt createtable my-table
cbt createfamily my-table cf1

# write two versions of the same cell, then read them back
cbt set my-table r1 cf1:c1=test-value1
cbt set my-table r1 cf1:c1=test-value2
cbt read my-table
و با GoogleSQL میتوان همان دادهها را Query کرد. در SQL، ستون ویژهی _key همان Row key است و هر Column family به شکل یک MAP دیده میشود. مثال زیر وضعیت سنسورها را در یک لحظهی مشخص از گذشته برمیگرداند:
SELECT _key AS location,
       alarmType['carbonMonoxide'] AS co_sensor
FROM alarms(as_of => TIMESTAMP('2023-04-01T09:00:00.000Z'))
WHERE _key LIKE 'building1%'
  AND alarmType['smoke'] = 'on';
بخش ۸ از ۱۲
کاربردهای رایج
دادههای سری زمانی و IoT: مصرف CPU و حافظهی سرورها، گزارش کنتورهای انرژی و دستگاههای هوشمند.
Ad-tech و بازاریابی: تاریخچهی خرید، ترجیحات کاربر و پروفایلهای لحظهای برای هدفگیری تبلیغات.
دادههای مالی: تاریخچهی تراکنشها، قیمت سهام و نرخ ارز.
شخصیسازی و یادگیری ماشین: Feature store، سیستمهای پیشنهاددهنده و اخیراً جستوجوی برداری و KV cache مدلهای زبانی.
دادههای گراف: ارتباط کاربران با یکدیگر.
بخش ۹ از ۱۲
مقایسهی Bigtable با BigQuery، Spanner و Firestore
ویژگی
Bigtable
BigQuery
Spanner
Firestore
نوع
NoSQL ستونگسترده و Key-value
انبار دادهی تحلیلی (Data warehouse)
رابطهای توزیعشدهی جهانی
NoSQL سندمحور (Document)
بار کاری اصلی
عملیاتی با توان بالا، سری زمانی، تحلیل لحظهای
تحلیل (OLAP) روی حجم عظیم داده
تراکنشی (OLTP) با سازگاری قوی
اپلیکیشنهای وب و موبایل
زبان Query
API کلید-مقدار، GoogleSQL، HBase و CQL
GoogleSQL کامل
GoogleSQL و PostgreSQL
SDK و Queryهای سندی
تراکنش
اتمیک در سطح یک ردیف
مناسب بار تحلیلی، نه OLTP
ACID کامل و توزیعشده
تراکنش ACID روی چند سند
تأخیر
چند میلیثانیه؛ زیر یک میلیثانیه با لایهی حافظه (In-memory tier)
ثانیه تا دقیقه
میلیثانیه
میلیثانیه
مقیاسپذیری
با افزودن Node، تا پتابایت
Serverless
افقی و جهانی
Serverless
مناسب برای
IoT، Ad-tech، مالی، شخصیسازی
گزارشگیری، BI و یادگیری ماشین
سیستمهای مالی، موجودی و رزرو جهانی
اپهای کوچک تا متوسط با همگامسازی لحظهای
بخش ۱۰ از ۱۲
چه زمانی از Bigtable استفاده کنیم و چه زمانی نه؟
مناسب است اگر…
حجم داده زیاد است (معمولاً از چند ترابایت به بالا) و به توان خواندن/نوشتن بالا با تأخیر کم نیاز دارید.
دسترسی به داده بیشتر بر اساس کلید یا بازهای از کلیدهاست.
دادهی سری زمانی، رویدادها یا پروفایل کاربران با اسکیمای منعطف دارید.
میخواهید از HBase یا Cassandra خودمدیریت به یک سرویس مدیریتشده مهاجرت کنید.
مناسب نیست اگر…
به تراکنشهای چندردیفی و چندجدولی و JOINهای پیچیده نیاز دارید (Spanner یا Cloud SQL بهتر است).
بار کاریتان عمدتاً تحلیل و گزارشگیری Ad-hoc روی کل داده است (BigQuery مناسبتر است).
حجم داده کم است؛ هزینهی ثابت Nodeها برای پروژههای کوچک اقتصادی نیست.
هر مقدار بسیار بزرگ است؛ مستندات رسمی مقادیر را معمولاً حداکثر حدود ۱۰ مگابایت توصیه میکند.
بخش ۱۱ از ۱۲
جمعبندی
Bigtable از یک سیستم داخلی گوگل که مقالهاش الهامبخش HBase و Cassandra شد، به یکی از کاملترین پایگاهدادههای NoSQL مدیریتشده تبدیل شده است. ستون فقرات آن همچنان همان ایدههای ساده و قدرتمند است: Row key مرتب، Column familyها، نسخهبندی با Timestamp، Tabletهای توزیعشده و جدایی محاسبه از ذخیرهسازی روی Colossus.
اما Bigtable امروز دیگر فقط یک Key-value store نیست: GoogleSQL، Continuous materialized views، Data Boost، سازگاری با Cassandra، Tiered storage و In-memory tier، جستوجوی برداری و ابزارهای ویژهی عاملهای هوش مصنوعی، آن را برای نسل جدید برنامههای لحظهای و مبتنی بر AI آماده کردهاند. اگر با حجم بالای دادهی کلیدمحور سروکار دارید، Bigtable همچنان یکی از جدیترین گزینههاست؛ به شرط آنکه طراحی Row key را جدی بگیرید.
راهنمای جامع و کاربردی مدیریت secret ها با HashiCorp Vault: تاریخچه، تغییر مجوز به BSL، OpenBao و خرید HashiCorp توسط IBM، مفاهیم Seal/Unseal و Raft، توکن و Policy، AppRole و Kubernetes، رازهای پویا، PKI و Transit، راهاندازی با Docker Compose و TLS، اتصال Spring Boot و چکلیست Production.
راهنمای جامع و کاربردی پراکسی سرور به زبان ساده: تفاوت پراکسی فوروارد، معکوس و شفاف، انواع HTTP و SOCKS، الگوریتمهای توزیع بار و آموزش کامل Nginx شامل نصب، ساختار پیکربندی، Reverse Proxy، SSL با Let's Encrypt، WebSocket، کش، محدودیت نرخ، هدرهای امنیتی و عیبیابی خطاهای 502 و 504.
راهنمای کامل و کاربردی WSO2: آشنایی با شرکت و محصولاتش، معماری API Manager نسخهی 4.7، نصب با Docker و Docker Compose، پیکربندی deployment.toml، راهاندازی SSL با Let's Encrypt و Nginx، نکات استقرار Production و مقایسه با رقبا.
نظرها هنوز نظری ثبت نشده
برای ثبت نظر، صفحه را در مرورگر باز کنید.